Off-Policy Learning: 方策オフ型学習
さて、今までは方策オン型学習というものをやっていた.
ここで学習には2種類の方策決定があり、
- ターゲット方策: 学習される方策
- 挙動方策: 挙動の生成に使われる方策
というものがあり、方策オン型学習ではどちらも同じ方策を使っている.
前回のブラックジャックで言えばBehaviorPolicyという方策に従っていた.
方策オフ型ではここが別々のものに分かれる...と言われても何だこりゃ...となると思う、自分はそうなった.
ということで、今回もブラックジャックを見つつ理解していくことにする.
本で言うところの例5.4を実際に組んでいる.
今回はブラックジャックの初期状態は以下のように固定する.
auto MonteCarloOffPolicy = [&](int episodes)
{
    // 初期状態を確定させておく
    Trajectory initState;
    initState.m_isPlayerUseAceEleven = true;
    initState.m_playerSum = 13;
    initState.m_dealerCardFirst = 2;

    // ...
};
ディーラーの1枚目は2.
この状態から毎回のEpisodeは始まるわけだ.
そして、まずは挙動方策,これは二項分布で決める.
挙動方策は前回で言うBehaviorPilicyのことで、ここが二項分布になるわけだ.
二項分布と言ってはいるが1回で50%の確率で成功する,つまり半々の確率でヒットかスタンドかを決めてるだけである.
// binormalによる選択
std::random_device seed_gen;
std::uint32_t seed = seed_gen();
std::default_random_engine engine(seed);
std::binomial_distribution<> dist(1, 0.5);
auto BehaviorPolicyPlayer = [&]()
    {
        return static_cast<Action>(dist(engine) == 1);
    };
これを使って実際にブラックジャックをプレイするわけだ.
プレイをするときまでは基本的に同じ.
    Array<double> rhos, weightedReturns;
    for (int i = 0; i < episodes; i++)
    {
        // 固定した初期状態で開始
        int reward = 0; Array<Trajectory> trajectories;
        Play(trajectories, reward, initState);
        // ...
    }
さて、そしてここで今回学習したいものであるターゲット方策!!
このターゲット方策はPolicyPlayerを利用する.
挙動は今までもやった通り、20か21の時だけStandするという戦略だった!
色々書いてあるけど、まずはターゲット方策はPolicyPlayerを使っているというのが重要.
        // 重要度の比率を用意
        double numerator = 1.0, denominator = 1.0;

        for (const auto& trajectory : trajectories)
        {
            if (trajectory.m_action == PolicyPlayer(trajectory.m_playerSum))
            {
                // 分母を1/2に、つまり値は大きくなる方向へ
                denominator *= 0.5;
            }
            else
            {
                // もし同じじゃないなら重要度0でbreak
                numerator = 0.0;
                break;
            }
        }
このように行動と推定には別の方式を使うというのが方策オフ型というものとなるわけだ.
ただ、別々の方策を使うため、単純に評価ができない.
こういう時に便利なのが重点サンプリング!!
自分もちょっと馴染みがある部分だとレイトレの期待値計算なんかはこれだね.
レイトレではモンテカルロ積分を求めるために期待値を計算する.
ただ、雑に光線を飛ばすのでは期待値の収束に時間がかかる...
そのため、光線を飛ばす方向をライトの方向に極力向くようにすることで効率化する.
これを堅苦しく言うと、単純な光線を飛ばすような分布の結果を得るためにライト方向に極力飛ばす分布を使うようにするということになる.
ライト方向に飛ばしても同じ結果が得られて、収束も早いならそっちを採用するべきだよね.
今回のもやることとしては同じことではあると思う.
20か21でスタンドするような分布で得られる結果を得るために、二項分布の行動を使うようにするというだけ.
それで収束が速くなるかどうかは別として、別分布でもちゃんと収束するよ.というのが大事なわけだ.
ちょっと本の中の式を追ってみよう.
ターゲット方策の中で初期状態$S_{t}が与えられたときの軌道は以下のような感じ.
これはブラックジャックで言うところのヒットするかスタンドするかがで、がその時の手持ちだったりディーラーの1枚目のカードだったりといった情報のこと.
この情報を基に次の行動をするかを決めているというのを掛け合わせたものが確率として表せるといえると思う.
そして、この確率をターゲット方策と挙動方策で考えたものが以下.
これを重点サンプリング率という.
基本的にはわからないことが多いので困ったものだけど、こうすると上手く相殺されるのが嬉しいポイント.
まずはこれを計算するところをコードで見てみよう.
まず今回はが分子だが、基本的に行動の基準は決まっていてそれ以外の行動は行えない.
あくまでは二項分布で自分の合計値が20だったとしてもヒットできるけど、は20と21はスタンド確定だ.
そのため、基本的にと行動が同じ場合は分子は1で、それ以外は0となる.
        // 重要度の比率を用意
        double numerator = 1.0, denominator = 1.0;

        for (const auto& trajectory : trajectories)
        {
            if (trajectory.m_action == PolicyPlayer(trajectory.m_playerSum))
            {
                // 初期値が1なので変える必要なし
                // ...
            }
            else
            {
                // もし同じじゃないなら重要度0でbreak
                numerator = 0.0;
                break;
            }
        }
分母となるの方はどうか?
二項分布の確率分布は以下の形だった.
今回,表と裏の出る確率は,つまり.
そして、1回のうち1回成功する確率を考えてみるととなる.
これより,
つまり、これで二項分布の場合の行動の数値が分かった.
1回成功する確率は,また失敗の場合もとなる.
成功をヒット、失敗をスタンドと言い換えればよいので、各行動でを掛けていけばよい.
        for (const auto& trajectory : trajectories)
        {
            if (trajectory.m_action == PolicyPlayer(trajectory.m_playerSum))
            {
                // 分母を1/2に、つまり値は大きくなる方向へ
                denominator *= 0.5;
            }
            else
            {
                // もし同じじゃないなら重要度0でbreak
                numerator = 0.0;
                break;
            }
        }
こうして重点サンプリング率が求まれば、重点サンプリングの係数を使って期待値の計算ができる.
価値関数が期待値という形に落とし込まれる.
期待値ということはこれまでのステップ数で割ることを考えると次のような感じになる.
しかし、これでは重点サンプリング比率が大きくなりすぎることで、収束が遅くなったりすることも多い.
そのため重み付き重点サンプリング(Weighted Importance Sampling)という方法を使うこともある.
要はステップ数で単純に割るのではなく重みも掛けましょうくらいの塩梅.式は以下の感じ.
さて、そしたらこの2つの重点サンプリングを行って、実際どうなのかを見る.
これが今回のゴール.
重みとなるものはrhosに保存.そして実際の期待値計算時の分子についてはWeightedReturnsに保存する.
WeightedReturnsは分子なので、Weighted Importance Samplingも通常のImportance Samplingも同じものとなるね.
次に各エピソード毎による部分和を形成.
これはC++ならpartial_sumで計算可能.
    // 合計を計算しておく
    Array<double> weightedSum(episodes, 0.0);
    Array<double> rhoSum(episodes, 0.0);
    std::partial_sum(weightedReturns.begin(), weightedReturns.end(), weightedSum.begin());
    std::partial_sum(rhos.begin(), rhos.end(), rhoSum.begin());
そしたらあとは計算するだけ.
通常のImportance SamplingはordinarySampling.
重み付きのImportance Sampling方はweightedSampling.
式の違いを見れば分かりやすい.
ただしrhoは0になることもあるため、この場合は0に強制的にする.
本にも分母が0の場合は0と定義と書いてあるので正しい.
最後はこれを結果として返すだけ!!
    // 系列を計算
    Array<double> ordinarySampling(episodes, 0.0);
    Array<double> weightedSampling(episodes, 0.0);
    for (int i = 0; i < ordinarySampling.size(); i++)
    {
        ordinarySampling[i] = weightedSum[i] / static_cast<double>(i + 1);
        weightedSampling[i] = rhoSum[i] != 0.0 ? weightedSum[i] / rhoSum[i] : 0.0;
    }

    return std::make_pair(ordinarySampling, weightedSampling);
今回の例はターゲット方策、つまり20,21でスタンドした際の期待値はわかっており,前々回に計算したときも同じ値になってるはずだけど-0.27726.
そのため、この値との差を見ればどれだけ値が近づいたのかが分かる訳になる.
エピソード数は10000とし、これを100回行うことで結果を平均してどれくらい近づいてるかを見ることにする.
const double trueValue = -0.27726;
const int episodes = 10000;
const int runs = 100;

まずは通常のものと重み付きを用意する.
そして、実際に計算!!
計算後はtrueValueとの差を求めてどれだけ近づいたのかを蓄積する.
```c++
// 結果
Array<double> errorOrdinaries(episodes, 0.0);
Array<double> errorWeighted(episodes, 0.0);

for (int i = 0; i < runs; i++)
{
    auto [ordinaries, weights] = MonteCarloOffPolicy(episodes);

    // powでスケール,trueValueに近くなればなるほど0に近づく
    for (int j = 0; j < episodes; j++)
    {
        double vOrdinary = ordinaries[j] - trueValue;
        double vWeight = weights[j] - trueValue;
        errorOrdinaries[j] += vOrdinary * vOrdinary;
        errorWeighted[j] += vWeight * vWeight;
    }
}
auto divides = [runs](double& v) { v /= runs; };
std::for_each(errorOrdinaries.begin(), errorOrdinaries.end(), divides);
std::for_each(errorWeighted.begin(), errorWeighted.end(), divides);
自分はSiv3Dで実装してるため、この辺を自分でスケールしなきゃいけないので最初違う図が出て迷った...
Siv3Dの場合は
Log10関数でスケールしてあげればよい.
さて、結果は以下のような感じ.
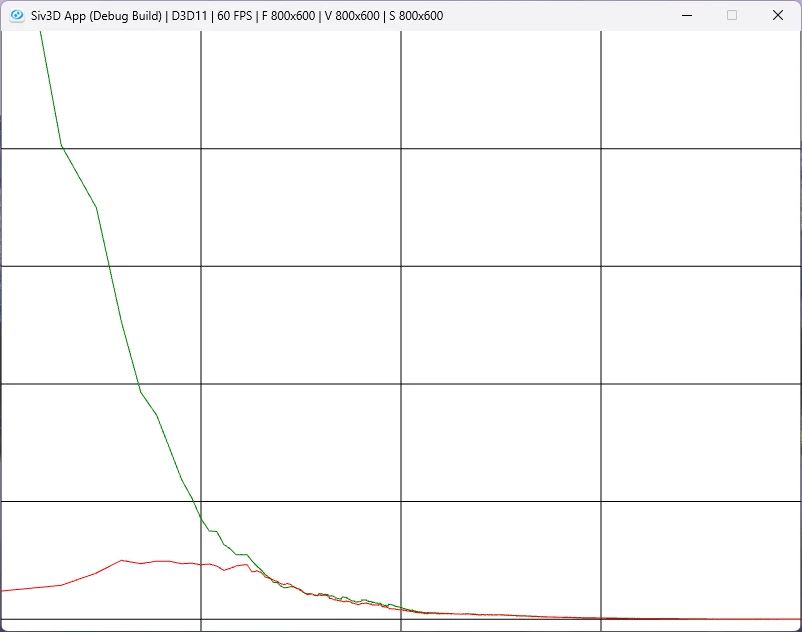
緑が通常の重点サンプリング,赤の方が重み付きの重点サンプリングである.
結果としては最終的には同じだけど,重み付きの方が誤差が最初の方から小さい.
これは実用上においても大抵はこのような結果になる.
レイトレなんかはこの誤差が小さいというのはそのままノイズがなくなり、画像の品質向上につながったりするのでこの誤差は非常に重要である.
今回の例ではまあ固定なのであまり感じられないかもだけども...
といったところで今回も終わり!